ChatGPTの回答に付く引用元は、モデルが記憶している知識から出てくるのではありません。その場でWebページを取りに行き、読み込んだ中から選ばれたものが出典として表示されています。
つまり「引用されるかどうか」は、そもそも取得の対象に入っているかという段階と、取得された中から選ばれるかという段階の、二つの関門で決まります。この記事では、その仕組みをOpenAIが公開している3種類のクローラーの役割と、引用元が確定するまでの流れに分けて整理します。
あわせて、当社が自社サイトを対象に2026年7月4日〜8月24日の48日間・1,416回観測した実測値も添えます。専門用語は初めて出てきたところで1行ずつ説明し、最後に費用をかけずに自分で確認する手順もまとめました。
記事執筆者:認定SEOコンサルタント 三田健司
ChatGPTの情報源は「学習データ」と「その場のWeb検索」の2階建て
ChatGPTの答えの出どころは、大きく二つに分かれます。ひとつは学習時に取り込んだ知識、もうひとつは質問を受けた瞬間に取りに行くWebページです。
学習データから答えているとき(引用元は付かない)
「株式会社とは何か」のような、変わりにくい一般知識を聞いたときは、Web検索を挟まずに学習済みの知識だけで答えることがあります。このとき回答の下に出典リンクは出ません。
学習データは特定の時点までの情報で固定されているため、その後に公開した自社ページの内容は反映されません。会社名を出してもらえるかどうかは、この段階では過去の露出量にほぼ左右されます。
Web検索して答えているとき(引用元が付くのはこちら)
「おすすめの〇〇会社は?」のように、最新性や地域性が関わる質問では、ChatGPTはその場でWeb検索を行います。この仕組みはRAG(検索拡張生成/Retrieval-Augmented Generation)と呼ばれ、外部から取得した文書を根拠にして回答を組み立てる方式です。
企業サイトが引用元として表示されるのは、ほぼこちらのルートに限られます。逆にいえば、Web検索が走らない質問では、どれだけページを整えても出典としては登場しません。
ChatGPTがページを取りに来る3種類のボット
OpenAIは、役割の異なる3つのユーザーエージェント(アクセスしてきたプログラムの名乗り)を公開しています。それぞれ目的が違い、robots.txtで個別に許可・拒否を指定できます。
GPTBot:モデルの学習用
GPTBotは2023年8月に公開された、将来のモデル学習に使う素材を集めるためのクローラーです。ここを拒否しても、ChatGPTの検索結果に出なくなるわけではないとOpenAIは説明しています。
自社の記事を学習素材として使われたくない場合に、ここだけを止めるという選択があり得ます。ただし止めた効果を外から測る手段はないため、判断は目的次第です。
OAI-SearchBot:ChatGPT検索の表示用
OAI-SearchBotは、ChatGPTの検索機能でWebサイトを表示するために巡回するボットです。ここを拒否しているサイトは、ChatGPTの検索回答に出典として出てこなくなります。
AI検索での露出を考えるなら、まず確認すべきはここです。セキュリティ設定やWAFの一括ブロックで、意図せず塞いでいるケースも見かけます。
ChatGPT-User:ユーザーの操作による取得
ChatGPT-Userは、利用者がリンクをクリックしたときや、その場でページを読ませたときに動く取得です。定期巡回ではなく、あくまで人の操作が起点になります。
この3つは独立して設定できます。学習は断りつつ検索露出は許可する、といった組み合わせも可能です。
引用元が決まるまでの4ステップ
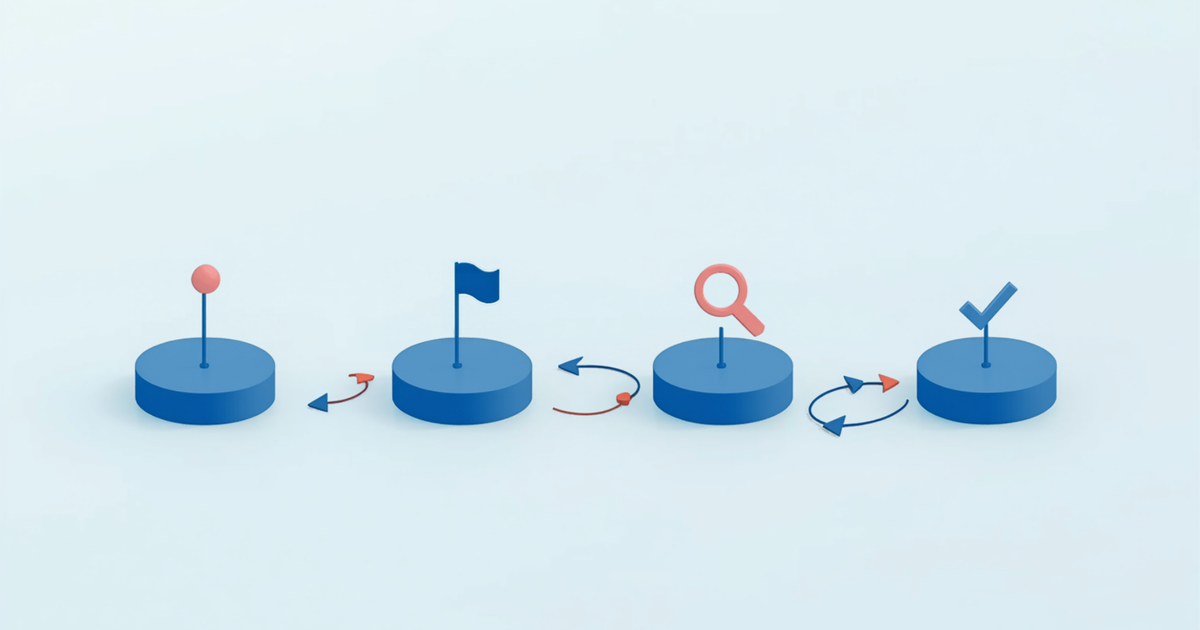
Web検索が走ったあと、引用元は一気に決まるわけではありません。おおまかに4つの段階を通ります。
①質問の分解 → ②候補ページの取得
まず、質問が複数の小さな検索クエリに分解されます。「下野市でおすすめのホームページ制作会社は?」なら、地域名+業種、比較、評判といった切り口に分かれるイメージです。
次に、その一つひとつに対して候補ページが集められます。この時点で拾われなければ、以降の選考にはそもそも参加できません。
③読み込みと照合 → ④引用の確定
集まった候補は読み込まれ、書かれている内容が他のページとも突き合わせられます。複数の情報源で一致する記述ほど、回答の根拠として採用されやすい傾向があります。
最後に、実際にリンクとして表示される出典が数件だけ選ばれます。読まれた枚数に対して、引用として表に出るのはごく一部です。
「読まれたのに引用されない」は普通に起きる
ここが実務上いちばん誤解されやすい点です。アクセスログにボットの来訪があっても、それは「候補に入った」だけで、引用されたことを意味しません。
逆に、名前だけ本文で触れられて出典リンクは別サイト、という形もよくあります。言及と引用は別々に数える必要があります。
実測データで見る「言及」と「引用」の差
ここからは当社の自社サイトを対象にした観測値です。観測期間は2026年7月4日〜8月24日の48日間、観測回数は1,416回、対象はChatGPT(OpenAI)・Gemini・Google AI Overviewsの3ソースです。
48日1,416回で、言及27.0%・引用19.9%
同期間の自社言及率は27.0%(382/1,416観測)、自社引用率は19.9%(188/946観測)でした。引用率の分母が小さいのは、出典URLが復元できないソースを除いているためです。
名前を出してもらえる場面より、出典リンクとして採用される場面のほうが明確に少ない、という関係がここに出ています。言及が取れているからといって、引用まで取れているとは限りません。
ソースが違えば、引用の付き方も違う
同じ48日間・同じ設問でも、ソース別に見ると差があります。ChatGPT(OpenAI)は476観測で言及率31.3%・引用率29.2%、Google AI Overviewsは470観測で言及率17.4%・引用率10.4%でした。
ChatGPTは言及したページをそのまま出典として示す割合が比較的高く、AI Overviewsはそもそも露出の入口が狭い、という傾向が読み取れます。一つのAIだけを見て判断すると、実態を読み違えます。
設問の性質で結果はまったく変わる
同じ48日1,416観測を設問別に分けると、社名を含む指名系の設問では自社言及92.9%・自社引用48.9%と高い一方、地域+業種の設問は言及83.0%・引用44.7%でした。
それに対して、汎用的な「おすすめは?」「選び方は?」といった6つの設問は、48日間を通して自社言及0.0%のままです。露出はサイト全体で一律に決まるのではなく、質問ごとに別々に決まります。
自分で確かめる手順(費用ゼロ)
仕組みが分かったら、まず自社の現状を自分で見に行くのが早道です。ツールを買う前にできることが三つあります。
手順1:robots.txtで3つのボットの扱いを確認する
ブラウザで「自社ドメイン/robots.txt」を開き、GPTBot・OAI-SearchBot・ChatGPT-Userの記述を探します。心当たりのないDisallowが並んでいたら、制作会社かサーバー会社に設定意図を確認してください。
記述が一つもなければ、原則としてどれも拒否していない状態です。WAFやセキュリティプラグイン側で別途弾いている場合もあるので、そちらの設定も併せて見ておくと安心です。
手順2:実際に質問して、出典URLを控える
お客様が使いそうな言葉でChatGPTに質問し、回答本文に自社名が出たか、出典リンクに自社ドメインが入ったかを別々にメモします。日付・質問文・結果の3列だけで十分です。
指名系・地域系・比較系の3タイプを最低1問ずつ用意すると、弱い場所が見えてきます。当社の実測でも、この3タイプで結果がはっきり分かれました。
手順3:同じ質問を日を変えて繰り返す
AIの回答は日によって揺れます。当社の観測でも、日次の自社言及率は48日間で20.0%〜33.3%の幅で動いていました。
1回だけの結果で良し悪しを決めると、たまたま出た日・出なかった日に振り回されます。週1回でも記録を残すと、傾向として読めるようになります。
引用されやすいページに近づけるためにできること
仕組みを踏まえると、打ち手は「候補に入る」ことと「照合に耐える」ことの二方向に整理できます。どちらも特別な技術は要りません。
結論を冒頭に置き、見出しを質問の形に寄せる
引用として抜かれる箇所は、記事の前半に集中しやすいとされています。前置きを削り、最初の数行で答えを言い切る構成にしておくと拾われやすくなります。
見出しも「〇〇とは」「〇〇の費用は」のように、人が実際に打ち込む言い回しへ寄せます。装飾的なキャッチコピーだけの見出しは、機械にとって手がかりが少なくなります。
数字と一次情報を持つ
照合の段階では、他のページと突き合わせられます。自社でしか出せない実績値や事例は、他所からのコピーでないことが分かりやすく、根拠として扱われやすくなります。
そのとき、数字には必ず期間と件数を添えてください。「効果があった」ではなく「〇年〇月〜〇月の12件で」と書くだけで、検証できる事実として扱われる余地が生まれます。
会社情報を機械が読める形で置く
社名・所在地・事業内容・代表者が、画像ではなくテキストで書かれているかを確認します。会社概要ページが画像1枚だけ、という例は今でも珍しくありません。
あわせて、同じ表記ゆれを社内で統一しておくと照合が通りやすくなります。株式会社の前株・後株、英語表記、屋号の使い分けあたりが典型です。
よくある質問
robots.txtでOAI-SearchBotを許可すれば、引用されるようになりますか?
許可は前提条件であって、引用を約束するものではありません。拒否していれば出典として出てこなくなる一方、許可しても選ばれるかどうかは内容と照合の結果次第です。
SEOで上位に出ていれば、ChatGPTでも引用されますか?
重なる部分はありますが、同じではありません。当社の48日1,416観測でも、検索で見つかる自社ページがあるにもかかわらず、比較・選び方系の6設問では自社言及が0.0%のままでした。
引用元がGeminiとChatGPTで違うのはなぜですか?
候補ページの集め方も、出典の示し方もサービスごとに異なるためです。当社の観測でも、同じ設問・同じ48日間でChatGPT(OpenAI)とGoogle AI Overviewsの自社言及率は31.3%と17.4%に分かれました。
関連記事
まとめ
ChatGPTの引用元は、質問を受けた時点で取りに行ったWebページの中から、読み込みと照合を経て数件だけ選ばれています。したがって「取得の対象に入っているか」と「照合に耐える中身か」の二つが要点になります。
まずはrobots.txtで3つのボットの扱いを確かめ、次に指名系・地域系・比較系の3タイプで実際に質問してみてください。当社の48日1,416観測でも、設問の性質によって自社言及は92.9%から0.0%まで開きました。
1回の結果ではなく、記録を残して傾向で見ることが判断の土台になります。手作業での記録が続かない場合は、定点観測を仕組みにしてしまうのが現実的です。
御社がどう紹介されているか、無料で診断
3つのAIに実際に質問し、御社と競合の出方をレポートにしてお送りします。
費用はかかりません。営業のご連絡もいたしません。
コメント