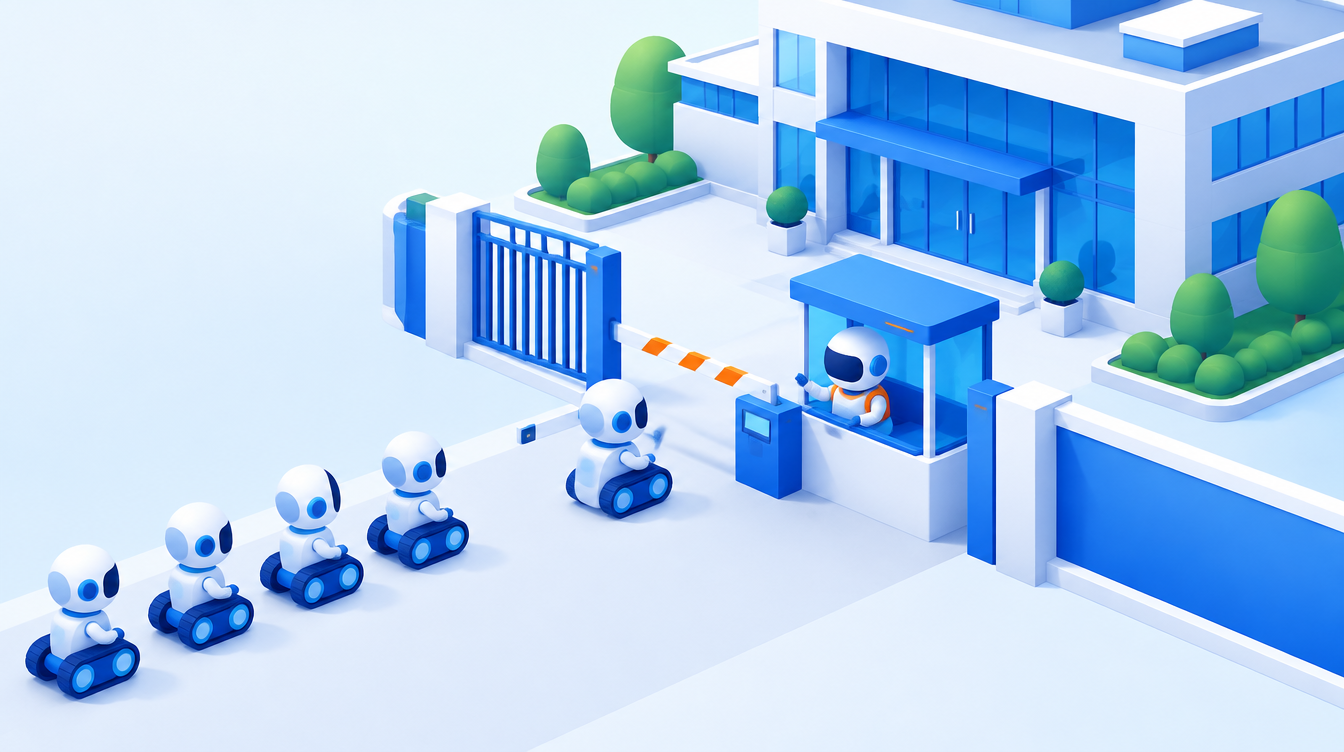
AIクローラー対策は、「学習用のクローラー」と「検索・回答用のクローラー」を分けて、目的ごとに許可とブロックを決めることです。
AI検索で会社名を出したい中小企業が、検索・回答用まで止めてしまうと、AIの回答や出典に載る機会を自分で減らすことになりかねません。
この記事では、主要なAIクローラーの名前と用途を各社の公式ページで確認したうえで、止める・通すの判断表とrobots.txtの書き方、設定後の確かめ方を順番にご紹介します。
クローラーの名前や仕様は変わることがあるため、本文の一覧は2026年10月20日に各社の公式ページで確認した内容です。
記事執筆者:認定SEOコンサルタント 三田健司
AIクローラー対策とは|「学習用」と「検索・回答用」を分けて考える
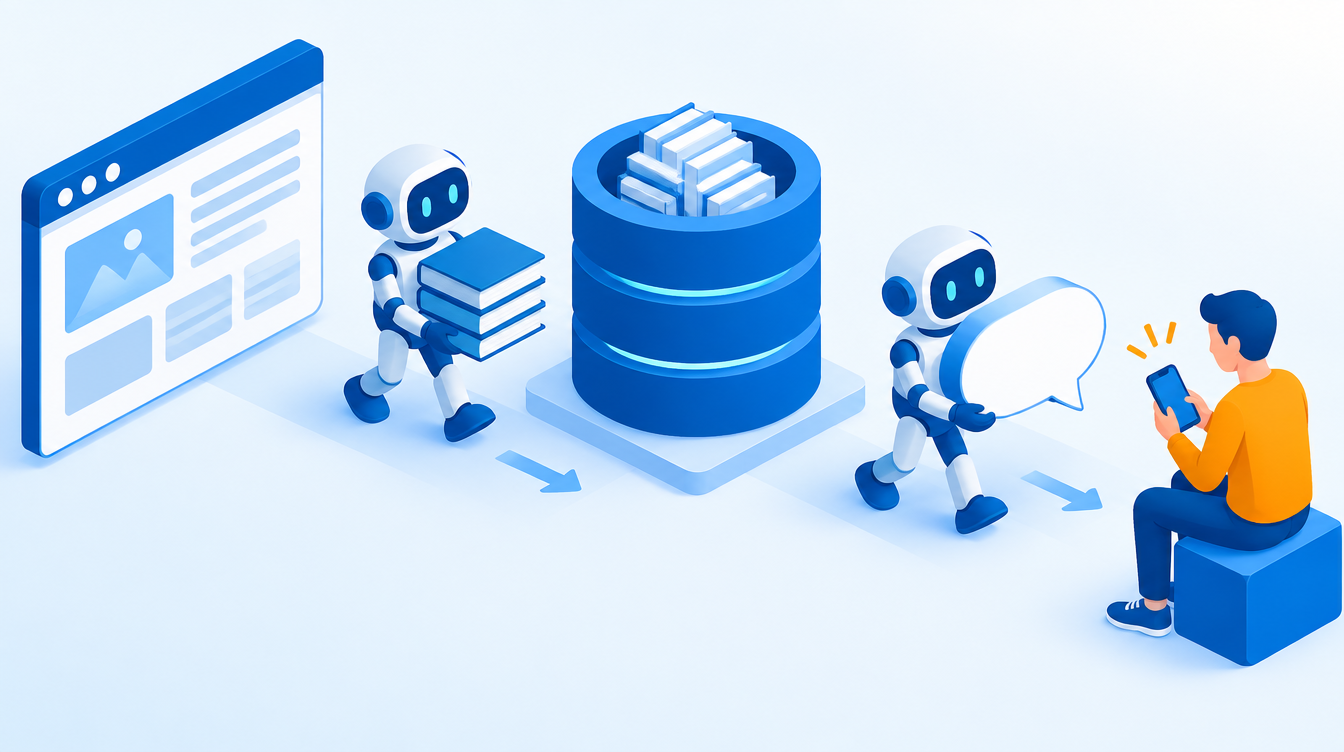
クローラーとは、Webページを自動で巡回して内容を集めるプログラムのことです。
AIクローラーは、そのうち生成AIの会社が動かしているもので、集めた情報の使い道によっていくつかの種類に分かれます。
学習用のクローラーは、AIモデルを作る材料を集める
1つ目は、AIモデルの学習に使う文章を集めるクローラーです。
OpenAIのGPTBotやAnthropicのClaudeBotがこれに当たり、ここで集めた内容は将来のモデルの知識の土台になる可能性があります。
学習用をブロックしても、すでに学習済みのモデルから自社の情報が消えるわけではありません。
ブロックの意味は、これから先の内容を学習に使わないでほしいという意思表示だと理解しておくのが正確です。
検索・回答用のクローラーは、AIの答えと出典を作る
2つ目は、AIが質問に答えるときに参照する検索用の索引を作るクローラーです。
OpenAIのOAI-SearchBot、AnthropicのClaude-SearchBot、PerplexityのPerplexityBotがこれに当たります。
3つ目は、利用者がAIに質問したその場で、AIがページを読みに行くための取得プログラムです。
ChatGPT-User、Claude-User、Perplexity-Userがこれに当たり、自動で巡回するクローラーとは性格が違います。
中小企業が最初に決めるのは「何を守り、どこに出たいか」
AI検索で自社の名前が紹介されることを狙うなら、検索・回答用のクローラーまで止めるのは逆効果になりえます。
一方で、有料の会員向けの記事や、独自に作った資料を学習に使われたくない、という考え方も筋が通っています。
どちらが正しいかではなく、自社のサイトで「守りたいもの」と「見つけてほしいもの」を先に分けることが、AIクローラー対策の出発点です。
主要なAIクローラーの名前と用途一覧(2026年10月20日確認)
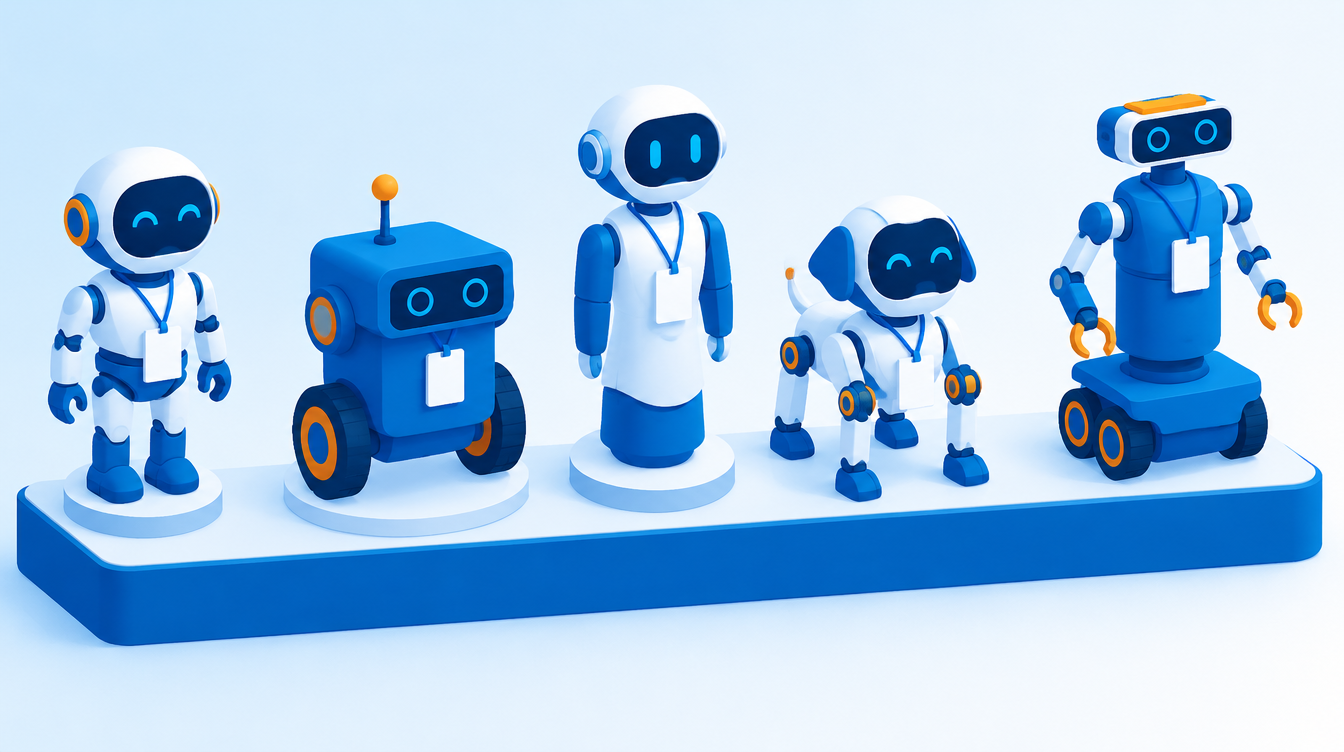
ここでは、各社の公式ページに書かれている名前と用途だけを整理します。
第三者のまとめ記事には古い名前が残っていることがあるため、設定の前には必ず公式ページを開いて確かめてください。
会社ごとのクローラーの一覧
| 会社 | 名前 | 用途(公式ページの説明の要約) | robots.txtの扱い |
|---|---|---|---|
| OpenAI | GPTBot | 生成AIの基盤モデルの学習に使う可能性のある内容を集める | 従う。ブロックは学習に使わないでほしいという意思表示 |
| OpenAI | OAI-SearchBot | ChatGPTの検索機能でWebサイトを表示するために巡回する | 従う。ブロックするとChatGPTの検索の回答に出なくなる |
| OpenAI | ChatGPT-User | 利用者の質問やGPTsの操作に応じてページを読みに行く | 利用者の操作が起点のため、robots.txtが適用されない場合がある |
| Google-Extended | Geminiの学習と、Geminiアプリ・Vertex AIでの回答の根拠づけへの利用を制御する目印 | Google検索への掲載と順位には影響しないと明記 | |
| Anthropic | ClaudeBot | AIモデルの学習用に内容を集める | 従う。Crawl-delayにも対応 |
| Anthropic | Claude-SearchBot | 検索結果の品質を高めるために巡回する | 従う。ブロックすると検索での見え方が下がる可能性 |
| Anthropic | Claude-User | 利用者の質問に応じてページを読みに行く | ブロックすると利用者の質問への回答に使われなくなる |
| Perplexity | PerplexityBot | Perplexityの検索結果でWebサイトを表示・リンクする。基盤モデルの学習には使わないと明記 | robots.txtで管理する |
| Perplexity | Perplexity-User | 利用者の質問に答えるためにページを読みに行く | 利用者の依頼のため、一般にrobots.txtを無視すると明記 |
OpenAIの公式ページでは、それぞれの設定は独立していると説明されています。
たとえば、OAI-SearchBotは許可してChatGPTの検索に出られるようにしつつ、GPTBotはブロックして学習には使わせない、という組み合わせができます。
GoogleのAI Overviewsは「Google-Extended」では止まらない
誤解が多いのが、Googleの検索結果に出るAI Overviews(AIによる概要)とAIモードの扱いです。
Googleの公式ドキュメントでは、Google-ExtendedはGoogle検索への掲載にも順位にも影響しないと書かれています。
AI Overviewsに出るかどうかは、通常の検索と同じGooglebotの巡回と、nosnippetやnoindexといった検索結果の表示の設定で決まります。
Googleの「AI機能とウェブサイト」の説明では、AI Overviewsに出るための追加の条件はなく、インデックスされてスニペットを表示できるページであることが前提だとされています。
Search Consoleにも生成AI機能への掲載の設定がある
Search Consoleのヘルプでは、設定の中に「Search generative AI」という項目があり、AI Overviews・AIモード・Discoverの生成AI機能への掲載を管理できると説明されています。
初期状態は「含める」で、除外するとそれらの機能からの表示回数やアクセスは得られなくなり、学習を止める設定でもないと明記されています。
中小企業が意図して除外する場面はほとんどないはずですが、以前の担当者が変更していないかは一度確認しておくと安心です。
画面上の日本語の表記はアカウントによって異なる場合があるため、項目名は英語のまま記載しています。
止めるか通すかの判断基準|目的別の判断表
AIクローラーをどう扱うかは、ページの種類と事業の目的で決めます。
ここでは、中小企業のサイトでよくあるページを例に、考え方の目安を表にしました。
ページの種類ごとの判断表
| ページの種類 | 学習用(GPTBot・ClaudeBot・Google-Extended) | 検索・回答用(OAI-SearchBot・Claude-SearchBot・PerplexityBot) | 考え方 |
|---|---|---|---|
| 会社概要・サービス紹介・料金 | 通す | 通す | AIに正しく紹介されたい情報。止める理由は少ない |
| ブログ・お役立ち記事 | 目的しだい | 通す | 集客が目的なら検索・回答用は通す。学習を避けたい場合だけ学習用を止める |
| ECの商品ページ | 目的しだい | 通す | 商品をAIの比較や回答に出したいなら通す。価格の自動収集が負担なら別の対策を検討 |
| 有料記事・会員限定ページ | 止める | 止める | そもそもログインで守る。robots.txtだけに頼らない |
| 管理画面・検索結果ページ・カート | 止める | 止める | AIに限らず巡回させる必要がない |
「全部ブロック」が向いている会社は多くない
報道機関や有料の情報を売る会社のように、文章そのものが商品であれば、学習用をまとめて止める判断には合理性があります。
一方で、地域の工務店や士業、製造業などは、文章ではなく自社のサービスが商品です。
AIに自社の名前やサービスが正しく説明されることのほうが価値は大きいため、少なくとも検索・回答用は通しておくのが基本だと考えます。
迷ったときは「出典に載りたいか」で決める
迷ったときは、ChatGPTやPerplexityの回答の出典欄に自社のページが載ってほしいかを考えてみてください。
載ってほしいなら、その会社の検索・回答用のクローラーは止めない、というのが判断の軸になります。
robots.txtの書き方と目的別の設定例
robots.txt(ロボッツテキスト)は、サイトの一番上の階層に置くテキストファイルで、クローラーに巡回してよい範囲を伝えるためのものです。
WordPressの場合は、SEO用のプラグインの設定画面から編集できることが多く、サーバーに直接ファイルを置く方法もあります。
基本の書き方は「User-agent」と「Disallow」
User-agentの行でクローラーの名前を指定し、その下のDisallowの行で巡回してほしくない場所を書きます。
「Disallow: /」はサイト全体を対象にするという意味で、何も書かない「Disallow:」はすべて許可という意味になります。
設定例1:学習用だけを止め、検索・回答用は通す
AI検索での露出を保ちながら、学習への利用だけを避けたい場合の例です。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
この書き方では、OAI-SearchBotやClaude-SearchBot、PerplexityBot、Googlebotは、最後の「User-agent: *」の範囲に従って巡回できます。
設定例2:会員ページだけをすべてのクローラーから外す
会員向けの階層だけを巡回の対象から外す場合は、その階層をDisallowに書きます。
User-agent: *
Disallow: /members/
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
ただし、robots.txtは「巡回しないでほしい」というお願いであり、ページを隠す仕組みではありません。
本当に見せたくないページは、ログインやパスワードで守ることが前提です。
設定後に必ず確認すること
robots.txtは1文字の書き間違いで、意図しないクローラーまで止めてしまうことがあります。
書き換えた日は、次の3点を必ず確かめてください。
ブラウザで実際のrobots.txtを開く
ブラウザで「自社のドメイン/robots.txt」を開き、書いた内容がそのまま表示されるかを確認します。
プラグインとサーバーの両方にrobots.txtの設定があると、片方の内容しか出ないことがあるため、表示された内容を正とします。
Search Consoleでrobots.txtの読み込みを確認する
Googleについては、Search Consoleの設定にあるrobots.txtのレポートで、Googleが取得した内容と取得日時を確認できます。
重要なページについては、URL検査でGooglebotがページを取得できるかも見ておくと確実です。
反映には時間がかかる
OpenAIの公式ページでは、robots.txtを更新してから検索の仕組みに反映されるまで約24時間かかると説明されています。
Googleも、再クロールには数日から数か月かかる場合があるとしているため、翌日に結果が変わらなくても慌てずに待つことが大切です。
アクセスログでAIクローラーの来訪を確かめる手順
robots.txtで許可していても、実際にAIクローラーが来ているかどうかは別の話です。
サーバーのアクセスログを見ると、どのクローラーがいつ来たかを確かめられます。
レンタルサーバーの管理画面からログを取り出す
多くのレンタルサーバーでは、管理画面の「ログ」や「アクセスログ」の項目から、日ごとのログファイルをダウンロードできます。
ログの1行には、アクセスした日時、読まれたページ、そしてUser-Agent(訪問者が名乗る名前)が記録されています。
クローラーの名前で検索して数える
ダウンロードしたログをテキストエディタで開き、「GPTBot」「OAI-SearchBot」「ClaudeBot」「PerplexityBot」などの名前で検索します。
どのページが何回読まれたかを月に1回メモしておくと、サイトの変更とクローラーの来訪の関係が見えてきます。
名前だけで本物と決めつけない
User-Agentは誰でも名乗れるため、名前が一致しても本物のクローラーとは限りません。
OpenAIやPerplexityは、自社のクローラーが使うIPアドレスの一覧を公開しているので、気になるアクセスはその一覧と照らし合わせて確認します。
robots.txtの限界と、ほかの手段
robots.txtは便利ですが、守ってくれるかどうかはクローラーの側にかかっています。
ブロックしたからといって、内容が完全に守られるわけではない点は理解しておく必要があります。
利用者の操作で動く取得プログラムは、robots.txtに従わないことがある
先ほどの一覧のとおり、ChatGPT-UserやPerplexity-Userは、利用者が質問したときにページを読みに行く仕組みです。
各社の公式ページでも、利用者の操作が起点のため、robots.txtが適用されない場合があると説明されています。
守りたい内容は、ログインやサーバー側の設定で守る
有料の資料や顧客向けの情報など、外に出したくないものは、ログインやパスワードの設定で守るのが基本です。
特定のアクセスを止めたい場合は、サーバーのアクセス制限やWAF(不正なアクセスを防ぐ仕組み)を使う方法もありますが、AnthropicはIPアドレスでのブロックが確実に効くとは限らないとしています。
llms.txtはrobots.txtの代わりにはならない
llms.txtは、AI向けにサイトの案内を書いておくファイルとして話題になりましたが、巡回を許可・禁止する仕組みではありません。
GoogleのAI機能向けのガイドでは、Google検索自体はllms.txtを使わないと明記されています。
AI検索に名前を出したい会社が気をつけること|実測データから
最後に、AIクローラーを止めないことが、実際の露出とどう関係するのかを、当社の観測データで見てみます。
アクセス・リンクのサイトは、robots.txtでAIクローラーを個別にブロックしていません。
97日・2,887観測で見た、出典に自社サイトが入った割合
当社は2026年7月4日から10月20日まで、97日間・2,887回、ChatGPT・Gemini・Google AI Overviewsに同じ10問を聞き続けています。
この期間に、回答の中で自社名が言及された割合は27.5%(794/2,887)でした。
ChatGPTでは、回答の出典に自社サイトのURLが含まれた回答が29.3%(283/967)、Google AI Overviewsでは10.4%(100/960)ありました。
Geminiは出典のURLが転送用の形式で記録されるため、この集計からは外しています。
出典にURLが載るのは、AIがそのページを読める状態にあることが前提です。
クローラーを許可したから出典に載る、という因果関係を示すデータではありませんが、検索・回答用を止めていれば、そもそもこの数字は生まれません。
許可しても、出るかどうかは中身しだい
同じ観測では、10問のうち6問で、97日間一度も自社名が出ていません。
クローラーを通すのは入口の条件にすぎず、AIに選ばれるかどうかは、ページの中身や会社の実績、ほかのサイトでの言及などで決まります。
設定を変えたら、変える前後で露出を比べる
robots.txtを変えたら、変更日を記録し、その前後でAIの回答に自社が出る割合が変わったかを比べてください。
1回だけAIに聞いても回答は日によって変わるため、同じ質問を一定期間続けて聞いたうえで比べることが大切です。
よくある質問
中小企業でもAIクローラー対策は必要ですか
大がかりな対策は必要ありませんが、自社のrobots.txtで意図せずAIクローラーを止めていないかの確認は、すべての会社におすすめします。
制作会社やプラグインの初期設定で、AIクローラーがまとめてブロックされていることもあります。
GPTBotをブロックすると、ChatGPTに出なくなりますか
OpenAIの公式ページでは、GPTBotとOAI-SearchBotの設定は独立しているとされています。
GPTBotをブロックしても、OAI-SearchBotを許可していれば、ChatGPTの検索機能で表示される可能性は残ります。
robots.txtでブロックすれば、内容は完全に守られますか
完全には守られません。
robots.txtはクローラーへのお願いであり、従わない取得プログラムもあるため、守りたい情報はログインなどの仕組みで守ってください。
関連記事
まとめ
AIクローラー対策は、学習用と検索・回答用を分け、自社の目的に合わせて許可とブロックを決めることから始まります。
AI検索で会社名を出したい中小企業は、少なくとも検索・回答用のクローラーを止めていないかを、今日のうちにrobots.txtで確かめてください。
設定を変えたら、反映を待ってから、AIの回答に自社が出る割合が変わったかを一定期間追いかけることが大切です。
自社がAIにどう紹介されているかを自分で確かめるのが難しい場合は、AccessGEOの無料診断もご利用ください。
御社がどう紹介されているか、無料で診断
3つのAIに実際に質問し、御社と競合の出方をレポートにしてお送りします。
費用はかかりません。営業のご連絡もいたしません。
コメント